Données personnelles coupées entre deux chunks : pourquoi un contrôle par chunk les laisse passer
Un garde-fou qui inspecte chaque morceau isolément laisse passer un numéro de carte s’il arrive en deux parties. Quatre projets sans code commun ont livré ce défaut indépendamment, un cinquième l’a documenté, et la classe porte désormais un nom et un DOI. Voici la reproduction, l’invariant qui l’élimine, et le test qui l’attrape.
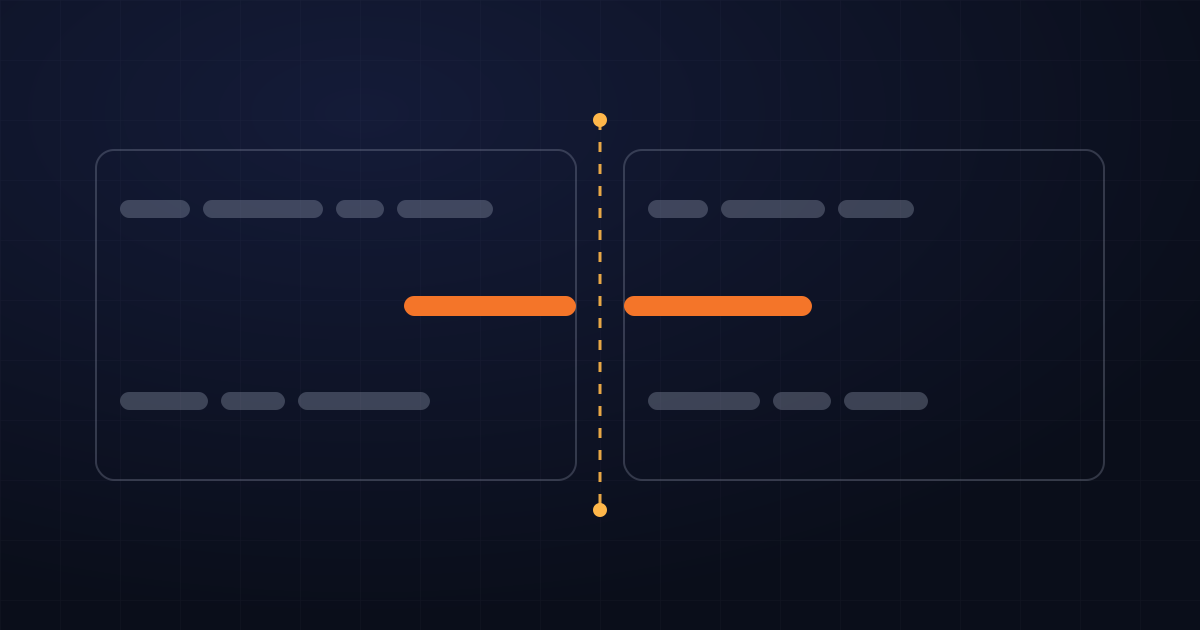
La reproduction : « user@exa » puis « mple.com »
Un modèle diffuse sa réponse en deltas découpés sur les frontières de tokens, pas sur le sens. Une adresse e-mail, un numéro de carte ou une clé d’API arrive donc couramment en morceaux :
chunk 1:  "...you can reach me at user@exa"
chunk 2:  "mple.com whenever you like."
Passez un motif d’e-mail sur le chunk 1 : rien. Sur le chunk 2 : rien. Les deux passent, les deux partent sur le réseau, et le navigateur les recolle en une adresse valide à l’écran. Ce même exemple en deux parties revient dans les rapports déposés contre plusieurs projets : premier indice qu’il ne s’agit pas de l’erreur d’une seule équipe.
Pourquoi un contrôle par chunk ne peut pas le voir
Le contrôle s’exécute sur une chaîne que le modèle n’a jamais considérée comme une unité. Les événements SSE transportent ce que le tokeniseur a produit : la coupure tombe donc n’importe où — au milieu d’un mot, d’un nombre, d’une clé. Traiter chaque delta comme un document complet, c’est poser la mauvaise question aux bonnes données.
Le réflexe suivant consiste à mémoriser un bout du morceau précédent. Cela aide à détecter et ne change rien à la fuite : quand la seconde moitié arrive et que le motif correspond enfin, la première est déjà partie. La masquer après coup modifie vos journaux, pas l’écran du lecteur.
Aucun texte ne doit sortir avant qu’il soit acquis qu’aucune correspondance ne peut encore s’y étendre. Détecter n’est pas empêcher.
Quatre projets l’ont livré indépendamment, un cinquième l’a documenté
Bases de code distinctes, langages distincts, équipes distinctes ; aucun rapport ne cite les autres. État vérifié le 24 septembre 2026 :
| Projet | Signalement | État |
|---|---|---|
| LiteLLM (Python) | #41611 — une valeur coupée entre deux chunks SSE passe les contrôles | Ouvert, déposé le 17 sept. 2026 |
| Mastra (TypeScript) | #23783 — PIIDetector émet les données en clair quand la correspondance est coupée | Corrigé en quatre jours (PR #24189) |
| LangChain (Python) | #35011 — le streaming contourne garde-fous et middleware | Corrigé le 10 juin 2026 (PR #37616) |
| NVIDIA NeMo Guardrails (Python) | #2375 — le rail de masquage en sortie inutilisable en 0.24.0 | Ouvert, déposé le 10 sept. 2026 |
| Vercel AI SDK (TypeScript) | #21209 — l’exemple de garde-fou laissait wrapStream non implémenté | Lacune de documentation, clos le 22 sept. 2026 |
La dernière ligne est d’une autre nature et mérite d’être distinguée : le SDK n’a livré aucun filtre défectueux. Sa page middleware montrait un exemple dont la moitié streaming restait en commentaire ; le lecteur qui la suivait écrivait donc la sienne — et c’est ainsi que quatre équipes ont réinventé les deux mêmes mauvaises conceptions.
La classe porte un nom : « split-boundary leaks »
Le 22 septembre 2026, Ninad Phalak a publié Split-Boundary Leaks in Streaming Guardrails sur Zenodo sous licence CC BY 4.0 — doi.org/10.5281/zenodo.22909585. Le rapport rassemble les quatre cas ci-dessus, traite celui de Vercel comme une lacune reconnue plutôt que comme un cinquième échec, et nomme la propriété qui manque aux quatre.
Deux précisions honnêtes. Le rapport émane d’un produit concurrent, et il n’examine ni ne recommande aucune bibliothèque, la nôtre comprise. Et le nom est le sien : si vous écrivez sur cette classe, citez le DOI plutôt que de la rebaptiser — une classe à un seul nom se retrouve plus facilement que la même sous quatre.
L’invariant : un résultat identique octet pour octet au filtrage du texte entier
Pour n’importe quelle façon de découper la même entrée, le résultat diffusé concaténé doit être identique octet pour octet au filtrage de la chaîne entière en une fois.
Cette seule phrase élimine tous les cas ci-dessus, et elle se teste par une assertion plutôt qu’elle ne se discute en revue. C’est la propriété à exiger d’une bibliothèque — et, comme le note le rapport, presque personne ne la publie comme contrat affiché, ce qui est pourtant ce qui permettrait de distinguer une implémentation correcte d’une implémentation plausible.
Votre bibliothèque vérifie-t-elle chaque chunk isolément ?
Trois vérifications qui répondent sans lire le code de personne :
- Couper une valeur connue à chaque position. Injectez la même entrée découpée de toutes les façons possibles et comparez le résultat concaténé au filtrage du texte entier. La moindre différence est le bogue.
- Observer quand le premier morceau sort. Si la sortie apparaît avant que l’analyseur ait pu voir la fin d’une correspondance, l’implémentation émet à l’aveugle.
- Chercher une taille dans la configuration. Une taille de tampon ou de fenêtre réglable signifie fenêtre fixe, et une fenêtre fixe a un bord — voir plus bas.
Avoir un tampon n’est pas retenir le texte
C’est la distinction qui piège de bons ingénieurs. L’état de détection et la politique de publication sont deux décisions séparées, et seule la seconde arrête une fuite. Le paquet IA d’Umbraco avait exactement cette forme : une fenêtre glissante qui détectait correctement pendant que chaque morceau partait à son arrivée. Le correctif fusionné le 22 septembre 2026 s’intitule « make streaming post-generate guardrails actually block/redact » : ce qui a changé, c’est la politique de publication, pas le détecteur.
Une retenue fixe de N caractères est une fuite paramétrable
Retenir les 20, 50 ou 64 derniers caractères, les préfixer au morceau suivant, analyser, émettre : cela fonctionne jusqu’à une correspondance plus longue que N — et cela échoue en silence, puisque la sortie a toujours l’air filtrée. LiteLLM promène un réglage stream_holdback_chars à travers huit fichiers source et, au 24 septembre 2026, zéro fichier de documentation : le nombre qui décide si vous fuyez est donc invisible pour la plupart des exploitants.
La documentation du Vercel AI SDK en donne désormais la forme générale, dans une note sous son exemple : une implémentation incrémentale doit retenir toute correspondance incomplète possible, et un tampon de taille fixe ne suffit pas pour des motifs de longueur variable non bornée. Un bloc de clé privée PEM ou un long JWT est précisément ce genre de motif.
Le correctif a son propre bogue
Deux défaillances qui arrivent avec la réparation :
- La corruption. Le masquage change la longueur de la chaîne ; découper le texte masqué avec des positions calculées sur le texte brut tombe au milieu d’un marqueur et mange de vrais caractères. Le rapport de Mastra mentionne ce cas à côté de la fuite.
- Les faux positifs au recollage. NVIDIA NeMo Guardrails #1197 décrit une espace insérée quand les tokens sont dépilés du tampon : avec un tokeniseur sous-mot, « assisting » arrive en « ass » + « isting » et atteint le rail de sortie sous la forme « ass isting », déclenchant une violation sur un mot qui n’existait pas.
« Tout mettre en tampon ou diffuser et fuir » est un faux dilemme
Il existe une troisième conception, la seule qui préserve le flux tout en satisfaisant l’invariant : à chaque morceau, calculer la position la plus lointaine au-delà de laquelle aucun motif ne peut encore s’étendre — le point de règlement —, émettre jusque-là, et retenir la fin. Sur du texte ordinaire, la queue retenue fait quelques dizaines de caractères : la sortie continue de couler.
Une décision doit y être prise explicitement, et c’est là que la classe revient : quand la queue retenue atteint son plafond alors qu’un motif de longueur variable est encore ouvert, l’implémentation relâche un texte qui peut être la première moitié d’un secret, ou refuse. Une queue bornée qui relâche au dépassement, c’est la fenêtre fixe sous un meilleur nom. Le comportement sûr est l’échec fermé.
Le test qui attrape toute la classe
Pas un nouveau framework : une assertion, exécutée sur chaque découpe de chaque cas :
for (const text of fixtures) {
  const whole = filterWholeString(text);
  for (let size = 1; size <= text.length; size++) {
    let streamed = '';
    const f = createFilter();
    for (let i = 0; i < text.length; i += size) streamed += f.push(text.slice(i, i + size));
    streamed += f.flush();
    assert.equal(streamed, whole);        // invariance au découpage
  }
}
Mettez un motif non borné dans les cas de test — un bloc PEM ou un long JWT — sinon la suite passera sur une implémentation qui relâche au dépassement. Ajoutez une valeur collée à du texte non ASCII, et une langue écrite sans espaces : une queue bornée par des délimiteurs de mots y grandit sans limite.
D’où vient ce texte
Nous publions llm-stream-guardrails, une bibliothèque MIT qui implémente la conception par point de règlement et affiche l’invariant comme contrat, et notre mainteneur est celui qui a signalé l’exemple non implémenté au Vercel AI SDK le 20 septembre 2026 ; trois pull requests de documentation s’y référant, ouvertes par l’automatisation du projet, ont été fusionnées deux jours plus tard. C’est l’intérêt à déclarer avant de lire ce qui précède comme neutre.
Tous les faits ci-dessus ont été vérifiés à la source le 24 septembre 2026, et non repris du rapport : états des issues et pull requests via l’API GitHub, enregistrement Zenodo et son PDF, documentation middleware sur la branche principale du SDK. Ce qui n’a pas pu être vérifié ne figure pas sur cette page.
Questions que posent les ingénieurs
Est-ce un bogue de mon framework, ou tout le monde l’a ?
Quatre projets sans lien l’ont livré indépendamment — LiteLLM, Mastra, LangChain et NVIDIA NeMo Guardrails — et deux de ces signalements étaient encore ouverts le 24 septembre 2026. Supposez que votre pile l’a tant que vous n’avez pas exécuté le test d’invariance au découpage.
Mon garde-fou évalue-t-il chaque chunk isolément ou garde-t-il un état ?
Coupez une valeur connue à chaque position, faites-la passer, et comparez le résultat concaténé au filtrage du texte entier. Si une seule découpe produit un résultat différent, l’évaluation est bien faite chunk par chunk, quoi qu’en dise la documentation.
Quelle taille de retenue choisir : 20, 50 ou 64 caractères ?
Aucune n’est sûre en soi. Tout N fixe échoue sur une correspondance de longueur N+1, et il échoue en silence puisque la sortie paraît filtrée. La quantité retenue doit découler des motifs recherchés, et l’implémentation doit échouer fermé quand elle atteint son plafond.
Puis-je simplement tout mettre en tampon puis filtrer ?
Oui, et c’est correct. C’est d’ailleurs ce que la documentation du Vercel AI SDK recommande par défaut. Le prix : vous cessez de diffuser. Le délai jusqu’au premier jeton devient le délai de génération complète, et la mémoire croît avec le bloc. Acceptable sur des réponses courtes, pénible sur les longues.
Que fait aujourd’hui l’exemple wrapStream du AI SDK ?
Depuis le correctif de documentation de septembre 2026, il garde un tampon par bloc de texte, y ajoute chaque delta sans rien émettre, puis, à text-end, masque le texte complet et l’émet en une fois. Cela ferme la faille des correspondances coupées ; les docs notent que cela retarde la sortie et consomme une mémoire proportionnelle au bloc.
L’issue LiteLLM est-elle corrigée ?
Pas au 24 septembre 2026. L’issue #41611 était ouverte, avec cinq commentaires, déposée le 17 septembre. Vérifiez par vous-même avant de vous fier à l’une ou l’autre réponse.
NVIDIA NeMo Guardrails est-il concerné ?
L’issue #2375, « output masking rail unusable in 0.24.0 », était ouverte le 24 septembre 2026. Une autre, #1197, documente un risque voisin : le recollage des tokens dépilés insère une espace, si bien que « assisting » peut atteindre le rail de sortie sous la forme « ass isting ».
Comment écrire un test qui l’attrape ?
Une assertion : pour chaque cas et chaque taille de morceau, la concaténation de la sortie diffusée doit égaler le filtrage du texte entier. Incluez un motif non borné, par exemple un bloc PEM, sinon le test passera sur une implémentation qui relâche au dépassement.
Le masquage a supprimé du texte correct. Pourquoi ?
Parce que masquer change la longueur de la chaîne. Si vous calculez les positions sur le texte brut puis découpez le texte masqué avec, vous coupez à l’intérieur d’un marqueur et perdez de vrais caractères. Gardez le tampon brut intact et ne masquez qu’à la sortie.
Qui a nommé la classe, et comment la citer ?
Ninad Phalak, dans « Split-Boundary Leaks in Streaming Guardrails », Zenodo, 22 septembre 2026, CC BY 4.0, doi.org/10.5281/zenodo.22909585. Citez le DOI plutôt que de rebaptiser la classe : un seul nom la rend trouvable pour l’équipe suivante.
Est-ce un dispositif de conformité ?
Non. Un filtre en flux est une défense en profondeur : il reconnaît des formats, pas du sens, et aucune bibliothèque ne rend un système conforme à quoi que ce soit. La conformité est une propriété d’un système et de son exploitant.
Le rapport recommande-t-il votre bibliothèque ?
Non. Il crédite notre compte GitHub une fois, pour le signalement de la lacune de documentation chez Vercel. Il ne nomme pas le paquet, ne l’examine pas et ne recommande rien — et il émane d’un produit concurrent. Lisez-le et jugez : le DOI est ci-dessus.